Gated DeltaNet: What Gets Forgotten, and What Gets Rewritten?
Residual writing explains gate order, interference, and causal chunking. Reproducible CPU checks clarify fixed-state limits and hybrid-model cache budgets.
What is retained when a growing context is placed in a fixed-size matrix? Gated DeltaNet does not simply store every historical key/value in another layout. It decays old state, predicts the current association, and rewrites memory using the prediction residual. The cost of fixed state appears in what is forgotten, what is overwritten, and which other queries change as a consequence.
This article examines Gated Delta Networks: Improving Mamba2 with Delta Rule by Songlin Yang, Jan Kautz, and Ali Hatamizadeh. It was first posted on December 9, 2024; I read v3 dated March 6, 2025 and checked the ICLR 2025 publication record. This is a detailed analysis of a foundational report, not a release today. The Qwen3-Next announcement of September 11, 2025 and Qwen3.5 announcement of February 16, 2026 provide public context for adoption in hybrid models; they do not mean that I independently validated whole-model performance. Published paper; v3 text; Qwen3-Next announcement; Qwen3.5 announcement.
1. Start with associative memory: the readout is not softmax
Consider only the mathematical core of one head. Token position is \(t\), query/key width \(d_k\), and value width \(d_v\). The state maps a key to a value:
Vectors are columns and the value dimension comes first in the state. Directional replacement below explicitly assumes \(\lVert\mathbf k_t\rVert_2=1\). Actual normalization includes epsilon; approximate unit length cannot silently become an exact equality. Readout scaling can be absorbed into \(\mathbf q_t\). Short convolution, output normalization, output gating, and projections are temporarily outside the core, not absent from the complete network.
With zero initial state \(\mathbf S_0=\mathbf0\), the smallest baseline is additive linear memory:
Each association contributes an outer product. The readout is a sum of values weighted by key/query inner products, without softmax’s exponential, positivity, or normalization guarantees. Repeated writes to one key accumulate, and similar keys interfere. This changes the memory operator rather than providing a lossless implementation of full softmax attention.
2. Delta writes the error; forgetting acts on old state first
Treat the state as a temporary linear predictor. A squared-error objective for the current association is:
It therefore does not merely store another \(\mathbf v_t\). It predicts \(\mathbf S_{t-1}\mathbf k_t\) and corrects the current association error. The update changes the session’s fast-weight state, not all trained model parameters during inference.
Gated DeltaNet adds old-state decay. The correct order is:
The standard original setting has \(0<\alpha_t<1\) and \(0<\beta_t<1\). Here, endpoints 0 and 1 illustrate limits or check implementations and are identified as such; finite sigmoid-based parameterizations do not guarantee exact endpoints. The residual must read the decayed state. Applying delta to the old state and then multiplying everything by \(\alpha_t\) also shrinks the new value and defines a different operator.
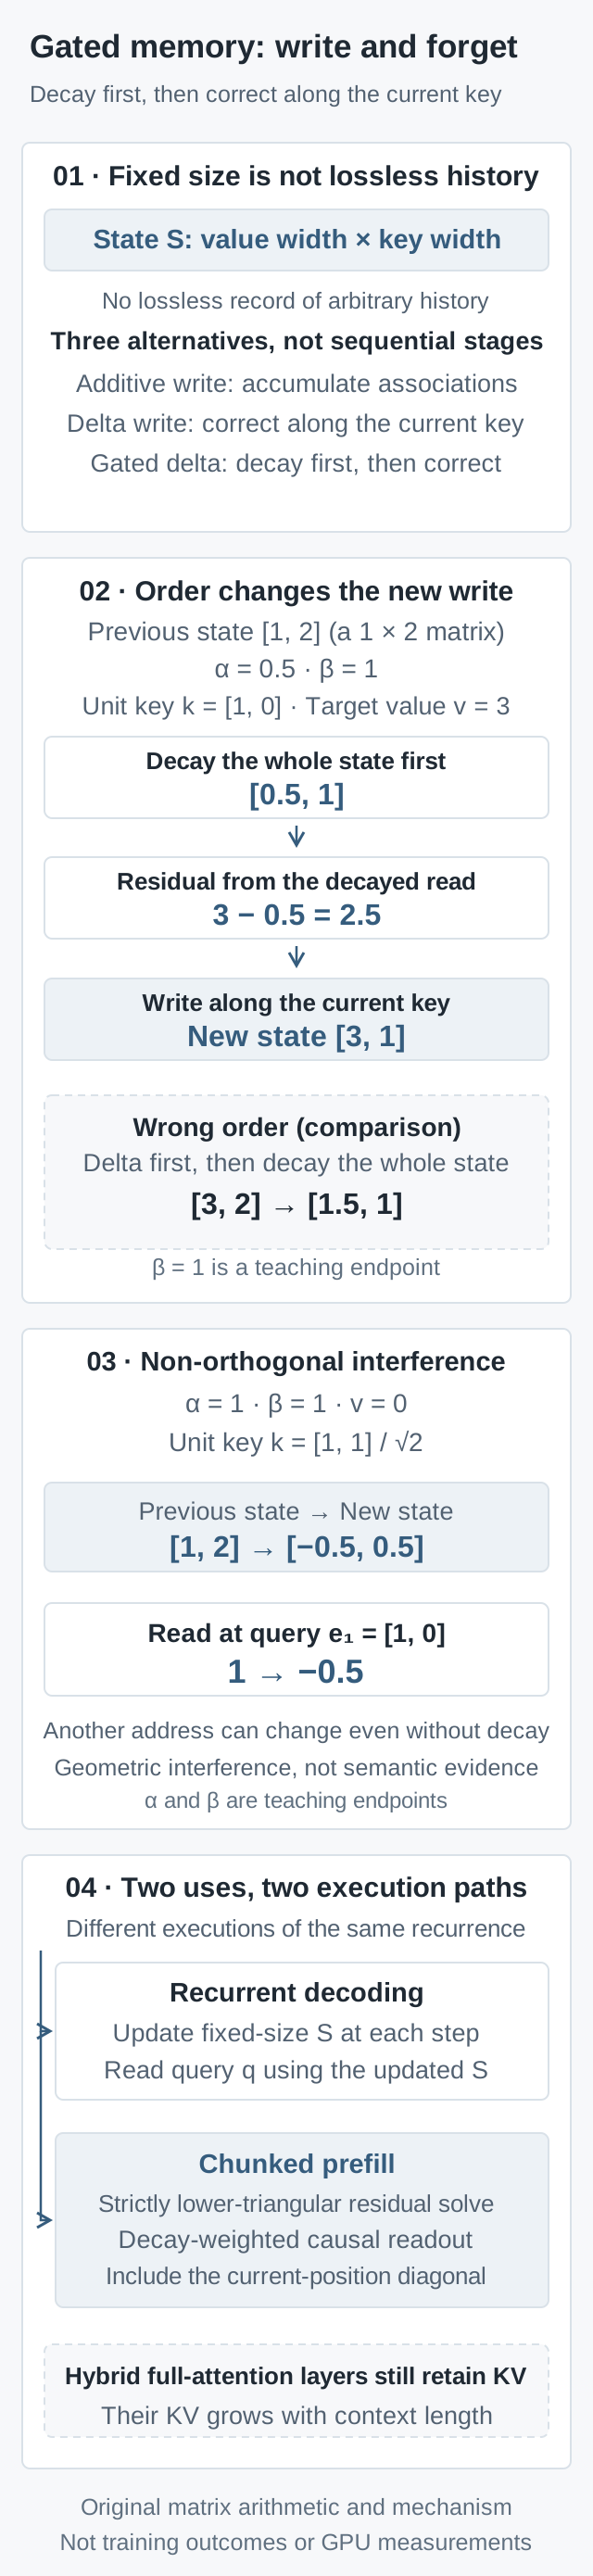
A synthetic example uses \(d_v=1,d_k=2\), old state \([1,2]\), \(\alpha=1/2,\beta=1\), key \([1,0]^\top\), and new value 3. Correctly, decay gives \([1/2,1]\), the residual is \(5/2\), and final state is \([3,1]\). Delta using the undecayed state followed by global decay instead gives \([3/2,1]\). This is matrix arithmetic, not model accuracy.
Original mechanism and synthetic matrix arithmetic. The correct order is global decay, residual computation from the decayed state, then a write along the unit key. With α=0.5, β=1, key [1,0] and target value 3, state [1,2] becomes [3,1]. The incorrect comparison applies delta first and then decays the whole state, giving [1.5,1]. A second endpoint example shows that a non-orthogonal key can change another query’s read; this is not a model semantic-retrieval result. Recurrent decoding and chunked prefill serve different execution uses; the latter has strictly lower-triangular residual dependencies and a decay-weighted readout including the diagonal. A fixed matrix is not lossless history, and hybrid full-attention KV still grows with context. These numbers are not training or GPU experiments; see the text for full recurrences and assumptions.
At \(\beta_t=1\), that key’s readout becomes exactly the target value. At \(\alpha_t=1\), it interpolates between the old prediction and the target. For a query orthogonal to the current key, however:
Query \([1,0]^\top\) now reads \(-1/2\) instead of 1, and the other coordinate changes too. Directional means a linear update along the key, not an independently identified semantic slot. Whether learned keys are separable, and which associations must coexist, determines the practical result.
Normalization also controls propagation of old state. The transition \(\alpha_t(\mathbf I-\beta_t\mathbf k_t\mathbf k_t^\top)\) has eigenvalues along the key and orthogonal to it:
Unit keys and the standard gate ranges ensure this step does not amplify an old-state perturbation. They do not establish stability of the whole input-driven network or its gradients. Without key normalization, even \(\beta=1/2\) with scalar \(k=3,\alpha=1,v=0\) maps old state 1 to \(-7/2\). A sigmoid beta alone is not a contraction proof.
4. A fixed terminal state cannot promise every past detail
There is no need for an overstrong claim about how many bits a real-valued matrix can store. A counterexample with interior gate values suffices. With scalar key 1 and \(\alpha=\beta=1/2\):
Two different value histories produce the same core terminal state. Given only final \(s_2\) and the same query, one cannot determine whether the first value was 4 or 0. Gates and keys are fixed in this example, which concerns one associative state. It does not prove that a whole network, including convolution caches, other layers, and hybrid attention, produces identical outputs. Required information must be tested by task; state size alone does not establish lossless storage of the entire history.
Setting \(\beta=0\) prevents writing but old state still changes if \(\alpha<1\). A core no-op requires \(\alpha=1,\beta=0\). The limit \(\alpha=0\) clears old state while the current token can still write. These are three different operations, not interchangeable ways to ignore a token.
5. Connect the equations to code: three gates and two orientations
I read the Qwen3-Next core and Qwen3.5 MoE call path at Transformers commit 4cc2aa84301c9aa210b5513dab9fefae03981f6e. This is source review, not execution of an official model. Code stores state as \([B,H_v,d_k,d_v]\), transposed relative to the single-head notation here. Key/query heads are repeated to value heads, each with its own state; the shared key-head count must not replace the state-head count. Pinned core implementation; Qwen3.5 call path.
Here \(a_t,b_t\) are input-projected gate signals, while \(A_{\log}\) and \(\delta\) are learned parameters for the corresponding head. The core receives \(\log\alpha_t\) as log-decay, not as the multiplicative gate itself. Q/K L2 processing includes epsilon; query is additionally divided by \(\sqrt{d_k}\). Value does not receive the same normalization.
Q/K/V also pass through short causal convolution and SiLU. Core readout is RMS-normalized and multiplied by an independent SiLU output gate before projection to model width. Decay, residual writing, and output gating control different interfaces. Calling all three an attention gate obscures the actual operations.
The following four lines implement only the raw single-head core in the column-vector convention. Q/K preparation and scaling must be specified outside it:
S = alpha[t] * S
r = beta[t] * (v[t] - S @ k[t])
S = S + np.outer(r, k[t])
out[t] = S @ q[t]
Sequence boundaries are part of implementation. Multiplying inputs by a padding mask need not implement the core no-op \(\alpha=1,\beta=0\); projection biases, gates, and convolution history still require checking. Packed independent samples need isolation of both associative and convolution states. Merely accepting a \(\texttt{cu\_seqlens}\) argument does not establish that a backend uses it. This pinned pure-Torch fallback accepts extra arguments without reading packed boundaries; specialized backends need separate validation.
Cache reset clears both convolution and recurrent states. A terminal matrix has no token axis whose tail can simply be removed; the corresponding cache marks itself non-croppable after recurrent initialization. Rollback needs checking of snapshots, replay, or another recording mechanism and its costs. Dropping trailing tokens alone does not restore earlier state. Source: pinned cache interfaces.
6. Parallel prefill starts by solving causal residual dependencies
Token recurrence explains decode well, but training or prefill cannot rely on tiny matrix operations becoming fast automatically. I derive a checkable chunk formulation directly from the recurrence; it is not a line-by-line claim about the official GPU kernel. Let chunk length be \(C\), incoming state \(\mathbf S_{\mathrm{in}}\), and within-chunk indices \(i,j\) start at 1. Define:
An empty product is 1. Products handle the teaching endpoint \(\alpha=0\) without a cumulative-product ratio that could yield \(0/0\). Expand the state and substitute it into the residual:
Residual \(\mathbf e_i\) depends on earlier residuals but not future ones. Stack Q/K/V/E as token rows with dimensions \(C\times d_k\), \(C\times d_k\), \(C\times d_v\), and \(C\times d_v\). With the strictly lower part:
This is a lower-triangular system with unit diagonal. Solve it or use an equivalent triangular transform rather than explicitly forming an inverse. Once all residuals are available, read each position and carry the terminal state:
Matrix \(\boldsymbol\rho\) already has causal upper-triangular zeros. Output includes the diagonal because the current token writes before readout; residual matrix \(\mathbf L\) must be strictly lower. These masks differ. Local readout also needs decay products: with scalar \(k_i=q_i=1\), \(\alpha_i=\beta_i=1/2\), and values \((4,0)\), the correct output is \((2,1/2)\). Omitting local decay incorrectly makes the second output \(3/2\).
The original paper uses extended WY/UT representations to organize within-chunk relations for hardware-efficient computation. The residual system above is an acceptance formulation rederived from equation (10). When reading the paper’s block-output expression, verify both causal diagonals and decay rather than copying the surface notation. Actual kernels handle decay through forms including log-space operations and arrange matrix computations. This reference retains within-chunk forward-substitution loops for readable verification. A computational chunk is not a sample boundary: the next chunk receives \(\mathbf S_{\mathrm{out}}\) rather than a fresh zero state. Source: pinned official implementation repository.
7. Constant state is a budget claim about an explicitly bounded core
For one sequence and one head, the decode core updates and reads in \(O(d_kd_v)\) per token and stores \(d_kd_v\) elements, independent of historical length \(T\). Width, value-head count, batch, and precision still affect actual cost. For the educational chunk formulation with fixed \(C\), total work is \(O(Td_kd_v+TC(d_k+d_v))\): outer products, incoming-state reads, and within-chunk K/Q pairings all count. Explicit local matrices need \(O(C^2)\) temporary elements. This is not a complete training-activation memory budget.
A hybrid model’s cache is better accounted for in parts:
Here \(\mathcal R\) denotes recurrent layers, \(\mathcal A\) full-attention layers, \(B\) batch size, \(H_v\) recurrent-state heads, \(H_{\mathrm{KV}}\) full-attention KV heads, and \(d_h\) their width. \(b_{\mathrm{state}},b_{\mathrm{KV}}\) are bytes per element and need not match. Convolution and other serving caches are separate. Weights, temporary buffers, and training backward activations are outside this cache formula.
The pinned text-decoder configuration of Qwen3.5-397B-A17B has 45 recurrent and 15 full-attention layers. Each recurrent layer stores \(64\times128\times128=1{,}048{,}576\) elements per sequence: if stored in FP32, that is a matrix budget of 4 MiB. Each full layer has \(2\times2\times256=1{,}024\) key/value elements per historical token. The latter still grows with \(T\). These are configuration calculations, not measured device memory. Source: pinned model configuration.
A fixed recurrent core therefore establishes neither constant whole-model memory nor higher speed at every length. Measure prefill and decode separately, recording batch, context, generation length, precision, backend, and actual caches. Whole-model comparisons also need comparable parameters, training data, and task quality. The paper’s main comparison uses 1.3B parameters, 100B FineWeb-Edu tokens, 4K training length, and 2K hybrid sliding windows. It is evidence reported for those settings, not a performance guarantee for Qwen models.
8. A reproducible mathematical check and remaining validation boundaries
I ran an original NumPy 2.3.5 CPU float64 check with seed 20261009, lengths \(\{1,2,5,17,33\}\), width pairs \(\{(1,1),(2,3),(7,4)\}\), three gate regimes—interior, teaching endpoints, and strong decay—and chunk lengths \(\{1,2,4,8,64\}\), with nonzero incoming states. Across 225 recurrent/chunk forward comparisons, maximum absolute output difference was \(4.44\times10^{-16}\) and maximum terminal-state difference \(2.22\times10^{-16}\), against tolerance \(10^{-11}\). These measure floating-point agreement in this check, not model performance.
Checks also cover the diagram’s update orders, nonorthogonal interference, distinct histories with the same terminal state, unnormalized expansion, inclusive output diagonals, a neutral core operation, and explicit independent-sample reset. A deliberately missing decay term fails. An independent reviewer verified the results using scalar expansion and irregular chunk partitions. Download the full original script to reproduce them. It needs NumPy and writes result JSON beside the script:
python3 gated-delta-memory-update.py
I did not run network weights, official CUDA/FLA kernels, backward propagation, or GPU performance experiments. Connecting this derivation to production calls for the following additional checks. They are proposed comparisons, not results obtained here.
Question
Comparisons and records
Meaning of acceptance
Core and chunk consistency
Identical Q/K/V and gates; nonzero initial state, chunk tails, tiny decay, different chunk sizes; output and terminal state
Verify the same recurrence, rather than accidentally similar final output
Precision and training
Actual dtype, kernels, and backward; gradient comparisons, high-precision references, long sequences, large values
Float64 forward agreement does not validate low precision or gradients
Padding, packing, and rollback
Independent versus concatenated samples, padding positions, convolution boundaries, snapshot restoration and replay
Verify isolation and cache lifecycle, without treating a mask as reset
Real retrieval and cost
Repeated/similar keys, distance to information that must survive, context switches; matched training/task budgets and separate prefill/decode measurements
Identify useful forgetting versus destructive overwriting and account for the whole model
Understanding Gated DeltaNet requires separating forgetting, residual writing, readout, and cache boundaries. Fixed-size associative state can carry part of sequence modeling, but retention must be learned and tested. Hybrid designs that add full attention must also include their sequence-growing resources in the budget.